Alla tjänster 
{opacity:0}@media%20(prefers-reduced-motion:no-preference){.iso-flow%3e*{opacity:0;animation:iso-flow%201.2s%20steps(1)%20infinite}.iso-flow%3e:nth-child(2){animation-delay:.4s}.iso-flow%3e:nth-child(3){animation-delay:.8s}}@keyframes%20iso-flow{0%25{opacity:1}33.333%25{opacity:0}}.iso-line{fill:none;stroke-linecap:round;stroke-linejoin:round;vector-effect:non-scaling-stroke}%3c/style%3e%3cg%20transform='scale(.5)'%3e%3cg%20class='iso-box'%3e%3cpath%20d='M-132%2060l243%20140%200%2016%20-243%20-140z'%20fill='%233a1d2a'/%3e%3cpath%20d='M242%20124l-131%2076%200%2016%20131%20-76z'%20fill='%2319000b'/%3e%3cpath%20d='M0%20-16l242%20140%20-131%2076%20-243%20-140z'%20fill='%235d4350'/%3e%3c/g%3e%3cg%20class='iso-box'%3e%3cpath%20d='M-97%200l208%20120%200%2060%20-208%20-120z'%20fill='%23ffdf80'/%3e%3cpath%20d='M208%2064l-97%2056%200%2060%2097%20-56z'%20fill='%23f0c552'/%3e%3cpath%20d='M0%20-56l208%20120%20-97%2056%20-208%20-120z'%20fill='%23fff3c4'/%3e%3c/g%3e%3cg%20class='iso-box'%3e%3cpath%20d='M-97%20-27l208%20120%200%2026%20-208%20-120z'%20fill='%2347adb2'/%3e%3cpath%20d='M208%2037l-97%2056%200%2026%2097%20-56z'%20fill='%23358f94'/%3e%3cpath%20d='M0%20-83l208%20120%20-97%2056%20-208%20-120z'%20fill='%23cfe8e6'/%3e%3c/g%3e%3cg%20class='iso-box'%3e%3cpath%20d='M-97%20-55l208%20120%200%2026%20-208%20-120z'%20fill='%2347adb2'/%3e%3cpath%20d='M208%209l-97%2056%200%2026%2097%20-56z'%20fill='%23358f94'/%3e%3cpath%20d='M0%20-111l208%20120%20-97%2056%20-208%20-120z'%20fill='%23cfe8e6'/%3e%3c/g%3e%3cpath%20class='iso-floor%20iso-dashed'%20d='M0%20-160l208%20120%20-97%2056%20-208%20-120z'%20fill='none'/%3e%3cpath%20class='iso-floor%20iso-dashed'%20d='M-97%20-104l208%20120%200%20164%20-208%20-120z'%20fill='none'/%3e%3cpath%20class='iso-floor%20iso-dashed'%20d='M111%2016l97%20-56%200%20164%20-97%2056z'%20fill='none'/%3e%3c/g%3e%3c/svg%3e)
AI-infrastruktur
Vi bygger plattformen för inferens, finjustering på era data och träning över flera GPU:er, från en server till en miljö som flera team delar.
Arbetslasten formar plattformen
- Inferens: svarstid, genomströmning, tillgänglighet och minne för modell och kontext.
- Finjustering: schemalagda jobb, dataset och spårbara experiment. Avbrutna jobb återstartas från checkpoint.
- Distribuerad träning: GPU-kommunikation, nätverksfabric, checkpoint-lagring och återstart efter fel.
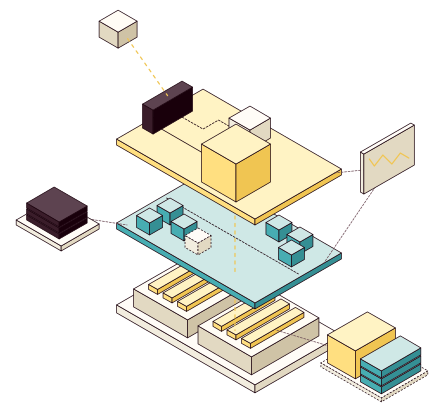
- API med autentisering och skydd, servingmotor som vLLM eller SGLang, modellversioner och routing.
- Kvoter mellan team, jobbplanering och insyn i GPU-användning, svarstid, fel och köer.
- Modell-APIAutentisering, nätverksskydd, routing och versioner.
- ServingmotorExempelvis vLLM eller SGLang med kapacitetskontroll.
- Kvoter och schemaläggningSeparera team och planera jobb och GPU:er.
- ObservabilityGPU, svarstid, fel och köer med larm.
- Data och modellerDataset, modellfiler, experiment och checkpoints.
- GPU-stödKubernetes-plugin, GPU Operator, Linux eller VM.
- GPU-servrarValiderade drivrutiner och container-runtime.
- GPU-minneModell och kontext per anrop.
Vad styr dimensioneringen?
Minnesbilden är schematisk, inte skalenlig, och utgår från lång kontext. Den visar mekanismer, inte ett kapacitetslöfte.
- Modellstorlek avgör vikternas minne och eventuell uppdelning över GPU:er.
- Samtidiga anrop påverkar genomströmning, köer och minne.
- Längre kontext kräver mer minne per anrop och påverkar svarstid.
- Lägre precision kan minska minnesbehovet, men kvalitet måste testas.
- Jämn last, toppar och batchjobb styr kvoter och delning.
- Modellvikter
- Kontext per anrop
- GPU-minne
- Ryms i en GPU
Linux, Kubernetes eller virtuell maskin
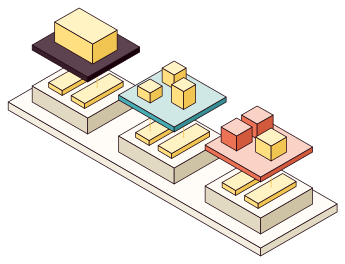
- Linux direkt på server för en modell eller ett jobb per server.
- Kubernetes på Talos för delade GPU:er, flera modeller, team och jobb.
- Proxmox-VM med GPU-passthrough när GPU-arbetslasten ska samsas med virtuella maskiner.
- Ny hårdvara dimensioneras efter arbetslasten och leverantörernas förslag jämförs.
- Linux
- Kubernetes
- Proxmox VE
- GPU-servrar
Från dimensionering till mätning
- Kartlägg modeller, anrop och data. Leverera arbetslastprofil och hårdvarubehov.
- Specificera GPU, CPU, minne, lagring, fabric och GPU-länkar samt rack, ström och kylning vid behov.
- Ni och era leverantörer köper och installerar hårdvaran.
- Konfigurera drivrutiner, container-runtime, GPU-stöd, kvoter, jobbmiljö, servingmotor, API och nätverk.
- Mät svarstid, genomströmning, minne och beteende vid fel och återstart med era anrop och data före produktion.
Ni kan driva plattformen
- Kod, arbetslastprofil, designbeslut, kompatibilitetsmatris och mätrapport är era.
- Runbooks för drift, uppgraderingar och återstart, med konton, nycklar och namngivna ägare.
- Teamet levererar ny modellversion via API, återstartar träning från checkpoint och uppgraderar drivrutiner i test.